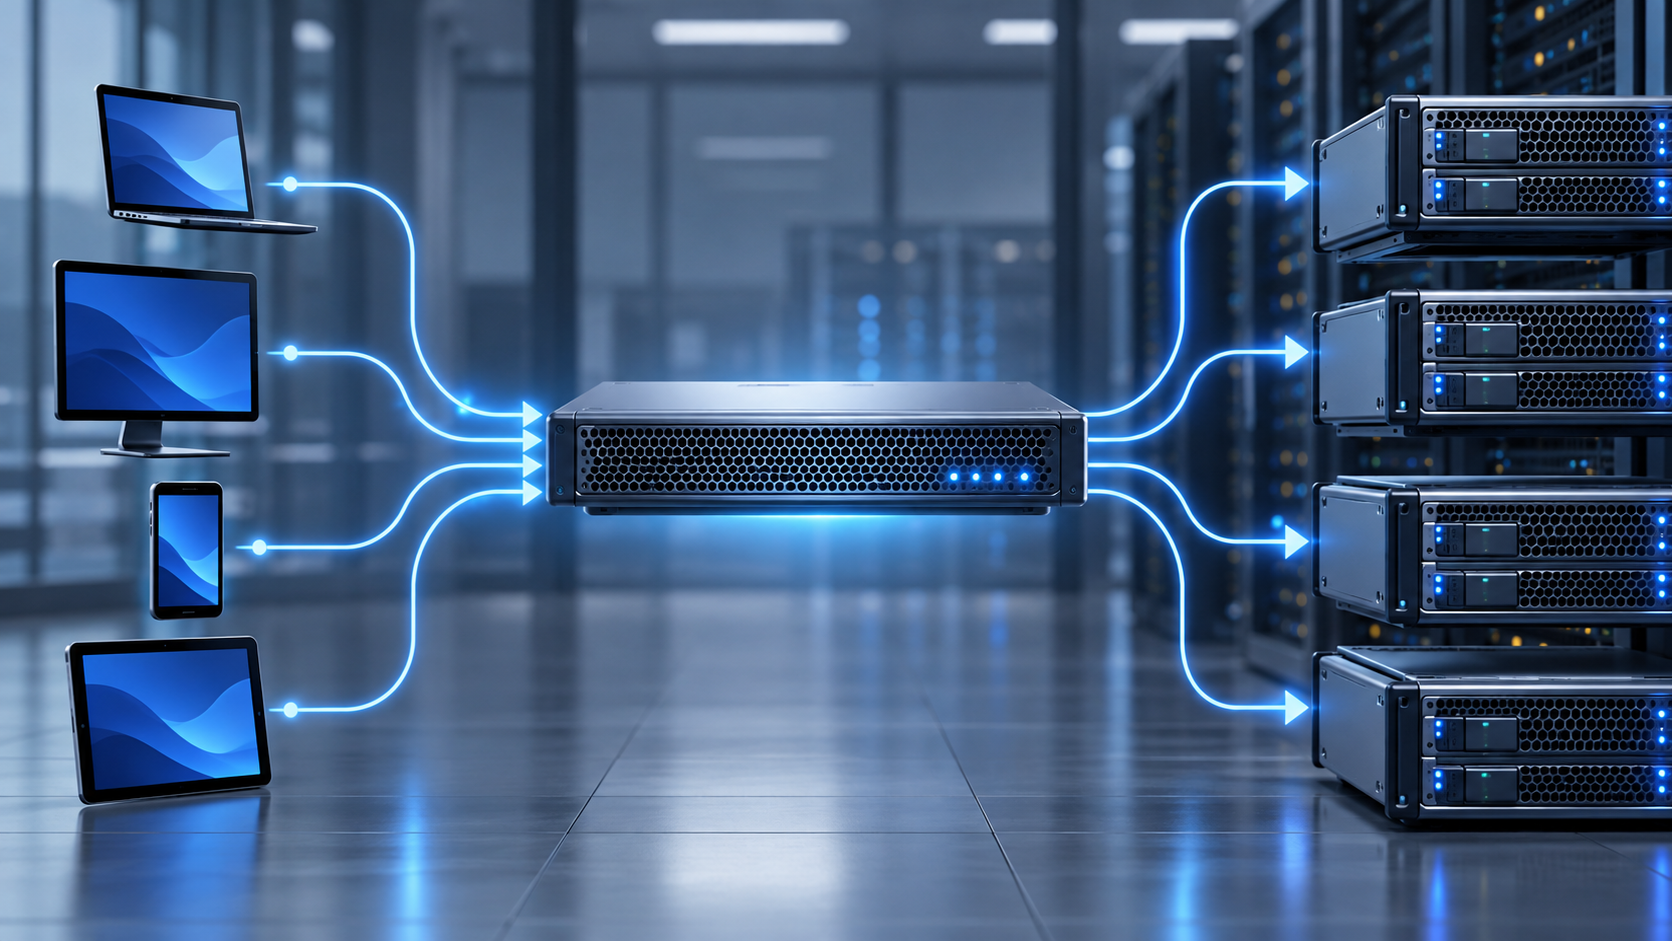
Балансировщик нагрузки нужен не только крупным интернет-магазинам. Любой сервис, для которого простой заметен пользователям, выигрывает от распределения запросов между несколькими узлами. Но само появление дополнительного компонента ещё не делает систему отказоустойчивой: важно убрать одиночные точки отказа и заранее продумать поведение при сбое.
При выборе решения российский балансировщик нагрузки оценивают вместе с архитектурой приложения, требованиями к сертификации и возможностями команды сопровождения. Список функций полезен, но реальную картину дают испытания на собственных протоколах, сертификатах и сценариях авторизации.
Проект начинают с карты потоков: откуда приходит трафик, какие сервисы его принимают, где завершается TLS и как приложение хранит пользовательскую сессию. Без этой схемы легко ускорить один участок и одновременно создать узкое место на другом.
Архитектура распределения трафика
Алгоритмы и состояние узлов
Round robin подходит не всегда: серверы могут отличаться мощностью и текущей загрузкой. Взвешенные алгоритмы учитывают эту разницу, а least connections помогает при долгих соединениях. Проверка состояния должна отражать готовность приложения, а не только доступность сетевого порта.
Сессии пользователей
Привязка клиента к одному узлу упрощает старые приложения, но снижает гибкость. Если состояние вынесено во внешнее хранилище, запросы можно распределять свободнее. Решение принимают после анализа приложения, иначе переключение при аварии приведёт к выходу пользователей из системы.
Резервирование самого балансировщика
Два узла вместо одного
Балансировщик тоже может отказать, поэтому критические схемы строят как минимум на двух экземплярах. Проверяют переключение виртуального адреса, синхронизацию конфигурации и поведение активных соединений. Резерв не считают рабочим, пока сценарий отказа не воспроизведён на испытаниях.
- описать потоки и целевые показатели доступности;
- настроить содержательные проверки здоровья;
- зарезервировать сам балансировщик;
- централизовать журналы и метрики;
- провести нагрузочные и аварийные тесты.
Ввод в эксплуатацию
Наблюдаемость и безопасность
До переключения пользователей собирают базовые показатели: задержку, число ошибок, активные соединения и нагрузку на узлы. Сертификаты, доступ к панели управления и журналы защищают так же тщательно, как само приложение. Изменения конфигурации фиксируют и проверяют на стенде.
Надёжность проявляется не в штатный день, а во время сбоя. Поэтому после запуска регулярно повторяют тест отключения узла и обновляют инструкцию для дежурной команды. Хорошо настроенный балансировщик делает аварию управляемой, но не заменяет резервирование базы данных и остальных зависимостей.
Перед окончательным решением полезно ещё раз сверить исходные условия, документы и практические ограничения. Спокойная проверка деталей обычно экономит больше времени, чем попытка исправлять уже выполненную работу. Если ситуация выходит за рамки обычного сценария, её стоит обсудить с профильным специалистом.